26 min #dev #opinion #pi-harness #pi #claude-code #coding-agents #tool-calling #llm
Sim, outro harness de coding agent§
Eu sei, eu sei. Sai um harness novo por semana, e cada um jura que é o definitivo. Esse aqui não é definitivo. É o meu: um punhado de extensões em cima do pi que fazem o agente pedir licença, perguntar em vez de chutar, e mostrar o que está acontecendo.
Mas antes de chegar nele, vale entender de onde vêm as opiniões que ele carrega. E, de quebra, desmistificar essa história de “dar ferramentas a uma IA”. Spoiler:

Sempre foi regex em cima de texto!
Sem tempo? O post em quatro linhas
- Programar é traduzir intenção em código. Um LLM é um interpretador de intenção, e o problema dele é o gap: tudo que estava na sua cabeça e não coube no prompt.
- “Tool calling” é um completador de texto rodando em loop, com uma regex em cima. Skills, workflows e companhia são nomes bonitos pra isso.
- Então um bom harness não é o que te tira do loop. É o que deixa barato entrar nele: negar com um motivo, responder uma pergunta, ver o que está rodando.
- Daí nasceu o
@adeildo/pi-harness. Não é fork:pi install npm:@adeildo/pi-harnesse pronto.
De onde vem essa mania de opinar§
Um script de 3 mil linhas e zero vergonha§
Comecei a programar lá pra 2020, quando finalmente tive meu primeiro notebook. Saí escrevendo meio mundo de script Python pra automatizar tudo que aparecia na frente, e pulando, com muito orgulho, tudo que dizia respeito a “Python profissional”. Não sabia o que era classe, o que era módulo… era tudo one-file-script.1
E de alguma forma funcionava. Eu olhava pra um script de 3 mil linhas, cheio de repetição, variável mal nomeada, função espalhada pra todo lado, sem type hint, sem teste, sem nada, e do alto dos meus 12 anos decorava tudo, sabia onde estava cada coisa e continuava lançando feature como um louco.
Bons tempos. Talvez de lá pra cá eu tenha tido um downgrade: hoje eu olho pra uma codebase daquelas e simplesmente  não consigo entender hahaha.
Perguntar “por quê?” pra tudo§
O que mudou foi que eu fui entendendo a motivação de cada coisa, e o que cada uma evitava. Por que eu preciso de teste? Por que eu preciso de type checking? Por que eu preciso modularizar? E a pergunta que eu mais gostava de fazer: como eu reescreveria isso aqui?
Eu nunca fiz dois projetos iguais trocando só as variáveis. Cada um seguia uma regra diferente: framework, capacidades, jeito de escrever. Isso mudou muito com o tempo e continua mudando (apesar da IA).
Um exemplo é este script que baixa cursos da Rocketseat, um dos poucos dessa categoria que deixei público (you know why, don’t you?). Lá no final tem uns comentários meus sobre como abstrair aquilo: e se uma plataforma de curso fosse uma árvore?
flowchart LR
    P["plataforma"] --> C1["curso"]
    P --> C2["curso"]
    C1 --> M1["módulo"]
    C1 --> M2["módulo"]
    M1 --> A1["aula"]
    M1 --> A2["aula"]
    A1 --> V["video.mp4"]
    A1 --> D["material.pdf"]
Cada nó só precisa saber listar os filhos. As folhas viram arquivo no disco.
Esse questionamento tem dois lados. O bom: me mantém atualizado. O perigoso: me faz pegar um projeto novo, tipo este aqui, sem dominar a tecnologia, e meter a cara mesmo assim, passando dia e noite construindo enquanto aprendo a própria ferramenta.
E ele me deixou com algumas opiniões que dá pra chamar de fortes, e que continuam sendo forjadas: sobre stack, ferramenta, jeito de desenvolver, fluxo de trabalho. Uma alergia a adotar coisa só pelo hype, e a mania de precisar saber o que acontece under the hood antes de começar a usar.
Então, por que não opinar sobre o que faz um harness ser “bom”? Nos meus termos, claro.
E Deus disse: haja IA!§
No fim de 2022 a OpenAI soltou o ChatGPT, em cima do GPT-3.5: o primeiro LLM que virou mainstream de verdade. No começo de 2023, eu estava fazendo curso de verão na FGV EMAp, dois ao mesmo tempo:
- Introdução à Programação com Python. Easy easy, eu tava lá só pelas horas de curso.
- Análise Real. Puta que pariu, que curso complicado. Eu tava morrendo, alguém me ajuda.
Como eu tinha muito tempo sobrando (contém ironia), peguei uma chave de API e escrevi um script simples:
sequenceDiagram
    autonumber
    participant S as meu script
    participant F as plataforma da FGV
    participant O as OpenAI
    S->>F: login com a minha conta
    F-->>S: exercícios não resolvidos
    loop cada exercício
        S->>O: enunciado + exemplos de entrada e saída
        O-->>S: código da solução
        S->>F: submete o código
    end
E foi assim que eu ganhei tempo: fazendo a IA escrever o código que eu teria que gastar tempo escrevendo. Passei com A+.2
Ali caiu a ficha: isso é uma puta solução. Tirando o custo de rodar um modelo desses, isso ia mudar o jeito que a gente escreve código. Se evoluísse até virar um interpretador de intenções bom o bastante pra ser uma camada de abstração entre mim e o código, ia mudar até o jeito que a gente usa linguagem de programação.
Liguei pro meu grande amigo Tiago Trindade, e a gente teve uma longa conversa sobre o que é ser programador e como seria o futuro… mas isso é história pra outro post.
Interpretador de intenções… mas como?§
Escrever código é, na prática, expor uma intenção de forma procedural: passo a passo, detalhado em linhas de código.
Exemplo: você precisa contar pro seu chefe (ou CTO) o que fez na última semana. Na mão, você vai no histórico de commits ou nas suas anotações, resume aquilo e manda. Essa é a sua intenção. Em código, ficaria mais ou menos assim:
from datetime import datetime, timedelta

github = GitHub(token=...)
slack = Slack(token=...)

since = datetime.now() - timedelta(days=7)  # (1)!

done = [
    f"- {repo.name}: {commit.message}"
    for repo in github.repos(org="minha-org")  # (2)!
    for commit in repo.commits(author="felipeadeildo", since=since)  # (3)!
]

slack.send("#daily", "O que eu fiz na última semana:\n" + "\n".join(done))  # (4)!
- “Última semana” virou os últimos 7 dias corridos. Não é de segunda a sexta, não é desde a última reunião. Você decidiu.
- Só os repositórios da organização. O side project de sábado ficou de fora. Você decidiu.
- “O que eu fiz” virou commits. PR revisado, call de duas horas, bug investigado que não gerou commit: nada disso conta. Você decidiu.
- “Contar pro chefe” virou mandar no canal
#daily. Não é DM, não é e-mail. Adivinha quem decidiu.
Clica nos marcadores do código: cada linha é uma decisão que só existia na sua cabeça. Escrevendo, você foi o tradutor da sua intenção pra código, que depois vai ser interpretado ou compilado e executado.
Um LLM como assistente de código faz exatamente esse papel de tradutor, só que de fora: você passa a intenção em linguagem natural (não em linguagem de programação), e ele se vira pra transformar aquilo em código.
flowchart LR
    I(["sua intenção"]) --> V["você escreve"] --> C1["código"]
    I --> P["prompt"] --> L["LLM escreve"] --> C2["código"]
    G["o gap: tudo que<br/>não coube no prompt"] -.->|falta| L
Em cima, zero camadas de interpretação. Embaixo, uma camada, e um buraco.
O problema é essa camada no meio (uma camada entre você e o código, basicamente). Quando você escreve o código, não tem interpretação nenhuma: você é a intenção, você é a janela de contexto, você sabe onde quer chegar. E quando falta alguma coisa, suas sinapses fazem o retrieval e fecham o gap na hora.
O LLM só tem o prompt. E o prompt nunca é tão profundo quanto o que está na sua cabeça, porque a gente é preguiçoso e odeia escrever especificação. Aí ele escreve diferente do que você imaginou. Não porque é burro: porque faltou informação. E, por design, ele não fecha esse gap sozinho, porque o que falta só existe na sua cabeça.
Então, se você quer a sua intenção virando código do jeito que imaginou, você precisa entrar no loop pra fechar esses gaps.
Guarda essa frase
Ela é a tese deste post. Tudo que eu construí lá no final existe pra deixar barato entrar no loop.
Como disse o Akita, no auge: “o ChatGPT é só um completador de texto glorificado”. Segura essa também, que ela vai ser útil daqui a pouco.
Uma breve (e enviesada) história das ferramentas§
1. Autocomplete no VS Code§
Mesmo assim eu tentei. A primeira versão foi uma extensão do VS Code pra completar código, que hoje não tem nem rastro no GitHub. Naquele começo, com janela de contexto minúscula, era muito mais fácil prever o que eu ia escrever do que escrever algo grande.
A ideia era simples: fiquei 5 segundos parado, ela mandava o arquivo pra OpenAI e me mostrava o resto.
Mágico! Funcionava que era uma beleza. Mas não bastava: numa codebase dividida em arquivos, fazia muito mais sentido mostrar os outros arquivos também, e a janela de contexto não deixava. Aí vieram a engenharia de contexto e as ferramentas de contexto sob demanda.
2. “Dar ferramentas” ao LLM§
O LLM precisava de uma coisa só: mais contexto, pra acertar mais em codebase grande. E a solução, nessa extensão, foi bem simples: inventar uma sintaxe pra chamar ferramenta, e explicar ela no system prompt.
Você é um agente de código especializado em terminar
código escrito por outro dev.

Na dúvida sobre o contrato de alguma coisa, explore com esta sintaxe:

>>> listar <pasta>
>>> ler <arquivo>

Exemplos:

>>> listar
pyproject.toml
src/
README.md

>>> ler src/core.py
def fib(n: int) -> int:
    return n if n in (0, 1) else fib(n - 1) + fib(n - 2)

Pare de escrever logo depois de uma chamada. O resultado aparece no lugar dela.
E o loop da extensão era mais ou menos isso aqui:
import re
from pathlib import Path

TOOLS = {
    "listar": lambda arg: "\n".join(p.name for p in Path(arg or ".").iterdir()),
    "ler": lambda arg: Path(arg).read_text(),
}
CALL = re.compile(r"^>>> (listar|ler) ?(.*)$", re.MULTILINE)  # (1)!

history = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": f"Complete o arquivo {path}:\n{path.read_text()}"},
]

while True:
    response = complete(history)  # (2)!
    calls = CALL.findall(response)
    if not calls:  # (3)!
        break
    results = "\n".join(TOOLS[name](arg) for name, arg in calls)  # (4)!
    history += [
        {"role": "assistant", "content": response},
        {"role": "user", "content": results},
    ]

print(response)
- A “API de ferramentas” inteira. Uma regex.
- O completador de texto glorificado. Ele não sabe que existe ferramenta nenhuma: só escreve texto que, por acaso, casa com a regex.
- Nenhuma chamada na resposta? Acabou, essa é a resposta final.
- Quem executa é o nosso código, não o modelo. O resultado volta pro histórico como mais um texto qualquer.
O de verdade era bem mais elegante que isso, mas a essência é essa:
flowchart LR
    H["histórico"] --> M["LLM completa o texto"]
    M --> R{"a regex achou<br/>uma chamada?"}
    R -->|sim| T["o SEU código executa"]
    T -->|o resultado vira texto| H
    R -->|não| F(["resposta final"])
Então é isso
Dar ferramentas a um LLM é fazer regex em cima de output estruturado. Não existe “poder” nenhum. É um completador de texto que a gente roda várias vezes, com uma regex em cima de cada resposta pra mapear o resultado numa ferramenta implementada na mão. Nada além disso.3
3. A era das CLIs§
Isso virou passado rapidinho. Foi aparecendo coisa muito mais legal, e o próprio VS Code começou a lançar coisas pra facilitar a integração com essas ferramentas de IA.
Até que alguém perguntou: precisa mesmo rodar dentro de uma IDE? Eu não preciso de IDE pra listar e ler arquivo, muito menos pra editar. Expõe uma tool edit com uns argumentos e boa.
E assim chegou a era das CLIs!!!
| Quando | Quem | O que trouxe |
|---|---|---|
| mai. 2023 | Aider | Quem começou. Nasceu junto com o GPT-4, e logo virou agnóstico de modelo |
| fev. 2025 | Claude Code | O mais maduro, mas focado no ecossistema da Anthropic. Ferramentas bem abstraídas, subagents em paralelo, e um monte de paradigma quebrado sobre o que é ambiente de programação |
| abr. 2025 | Codex CLI | Sinceramente, uma bosta no lançamento (hoje melhorou muito). Basicamente uma tool só, shell, num modelo que ainda não sabia usar shell Unix |
No Codex daquela época, list era shell("ls"), read era shell("cat arquivo.ext") e edit era shell("sed ..."). O modelo não tinha refinamento pra isso, e dava pra sentir.
Quem fez isso muito bem, e continua fazendo enquanto escrevo, foi a Anthropic. Claro que pra isso o modelo também teve que evoluir: uma camada de pós-treinamento só pra chamar ferramenta, vulgo escrever bons JSONs no formato especificado.
4. Onde a galera perdeu a linha§
Repara: na prática, um LLM não precisa de mais de duas ferramentas pra se virar.
- Num arquivo, devolve o conteúdo. Numa pasta, devolve o que tem dentro.
- Troca
oldpornewno arquivo. Só.
Fun fact
Passa ano, entra ano, e a gente não consegue fugir do input/output.
O resto é conforto:
- search: nada mais que um
grep. Se quiser luxo, um grep em cima da AST. - bash: esse é maravilhoso, porque com um modelo bom o bastante (não era o caso da OpenAI no começo de 2025), só ele já abstrai o
reade oedit.
A galera se perdeu quando o hype começou. Foi uma loucura: muita desinformação sobre as capacidades, muita gente falando merda na internet, e todo mundo achando que estava tudo perdido, porque se o LLM “escreve código melhor que eu”, com as ferramentas certas ele me substitui. Que bagunça isso virou.
Do nada, 1001 ferramentas, tools, workflows, skills e não sei o quê lá. Mano, tudo isso é regex em cima de output estruturado, pra trazer contexto sob demanda e executar ferramenta. Mas o mundo precisava de hype, então deram 1001 nomes pra input/output condicional a um match de regex. Louco, né?
| O nome bonito | O que é de verdade |
|---|---|
| Tool calling | O modelo escreve um JSON, o harness faz o match e executa a função |
| Skill | Um prompt num .md, hospedado num skills.sh da vida. Um Ctrl+C Ctrl+V com marketing |
| MCP | Um servidor que lista as próprias tools e responde quando chamam |
| Subagent | O mesmo loop rodando de novo, com o histórico limpo |
Onde o Claude Code me perdeu§
Por um bom tempo, o Claude Code foi pra mim o estado da arte de harness de CLI. Introduziu vários conceitos legais, úteis de verdade, que dão um bom controle pra quem usa.
Só que ele é de uma empresa privada, com o objetivo de controlar o mercado, e o harness ficou quase impossível de usar fora de um modelo da casa. Funcionalidades ótimas… que só funcionam bem se o seu provider for a Anthropic, ou um gateway dela. E por vários motivos:
- System prompt do tamanho de uma Bíblia. Iniciar uma sessão com modelo local, numa máquina normal, fica simplesmente lento demais.
- Assinaturas de tool difíceis de representar, a não ser que o seu modelo tenha passado por um pós-treinamento específico pra aquele caso de uso.
- Auto mode com critério proprietário. Quem decide o que é aceito sozinho é a Anthropic, e nem sempre ela faz um bom trabalho nisso.
Resumindo: a maior dificuldade é rodar coisa diferente dentro da carcaça do Claude Code. Só isso.
Sim, eu sei que dá pra trocar o endpoint
Dá pra definir profiles com endpoints diferentes. Eu inclusive escrevi um gestor de contas do Claude Code que usa exatamente isso. Só que isso não resolve o resto da lista.
Procurando casa nova§
Na busca por alternativa, passei por opencode, opencode2, aider, hermes, fx.sh e por aí vai. Cheguei até a revisitar o codex (que melhorou muito, btw).
Só que todos eles, por algum fucking motivo, assumiam que eu quero fazer as coisas one-shot, sem human-in-the-loop: sem eu dar feedback, responder pergunta, permitir ou negar alguma coisa. Nem todos tinham tudo, mas a maioria compartilhava estas deficiências:
- Editar tudo by default. Começavam com permissão pra editar qualquer coisa, o que eu acho ousado demais.
- Visibilidade truncada. Qual arquivo, o quê, por quê, o thinking, a decisão: tudo meio escondido.
- Permissão binária. O diálogo era
yesounoe só. Se eu negasse, o agente recebiathe tool call was denied by the usere mais nada: sem motivo, sem follow-up. Lembra do gap? Pois é: eu negava e o gap continuava lá, intacto. - Não eram o Claude Code. Uma funcionalidade bem feita de um lado, outra bugada do outro.
- Performance.
Guarda essa lista. Ela volta no final.
Amor à primeira vista: pi.dev§
Até que um amigo, o Bruno Assis, me apresentou o pi.dev. Foi amor à primeira vista.
Minimalista, extensível, direto ao ponto. Uma página em branco esperando pra ser pintada! Bem mais perto de outras TUIs, e com opiniões fortes sobre o que é uma tool.
Sem tempo pra fazer o meu (ainda): Oh My Pi§
Fazer um bom harness leva tempo, então fui ver o que a comunidade já tinha feito em cima disso. Conheci o Oh My Pi, que não podia ter nome melhor pra uma versão opinionated hahaha. Simplesmente perfeito: TUI ótima, bonita, configurável, cheia de coisa útil de verdade.
Mas ainda falhava em algumas coisas. O feedback ao aceitar ou negar uma tool, por exemplo. E não tinha política tipo “accept edits” ou “manual mode”: era 8 ou 80, sem meio-termo configurável.
Usei por um bom tempo, é um trabalho excelente. Mas tem uma pegadinha:
O omp não é o pi
É um fork do pi, atualizado com o upstream. Tipo o que o Arch Linux é pro kernel Linux. Isso não é problema nenhum, só é bom ter em mente.
pi puro + extensões, sem fork§
Depois de uma overdose de funcionalidade no omp, e já sabendo o que era possível fazer, voltei pro pi e fui olhar a lista de extensões. Algumas merecem meus devidos respeitos:
-
Uma interface limpa e bonita em cima do pi, e configurável.
-
Um diálogo bem Claude Code pro LLM te fazer perguntas: fechar o gap de informação e decidir junto com você.
-
Intercepta o stream da API da Anthropic e injeta os headers do Claude Code CLI, pra cobrar da assinatura em vez do extra usage. (De novo, Anthropic: por quê?)
-
Mais de uma conta pro mesmo provider, tipo Anthropic pessoal + Anthropic da Ranqia. A mesma ideia do meu claude-code-profiles.
-
Busca e leitura da internet pro LLM, com resumo.
-
Memória em markdown puro: fatos e decisões duráveis, um log diário e um scratchpad. Com o qmd, ganha busca por palavra-chave, semântica e híbrida.
Entre outras! Foi um mundo novo.
A extensão que faltava: pi-ask-permission§
Ainda faltava uma do meu gosto, e pelo jeito a experiência que eu queria só ia existir se eu mesmo fizesse. Nasceu a pi-ask-permission (deprecated, ok?): antes de qualquer tool que não seja só leitura, ela me pede permissão, numa interface assim:
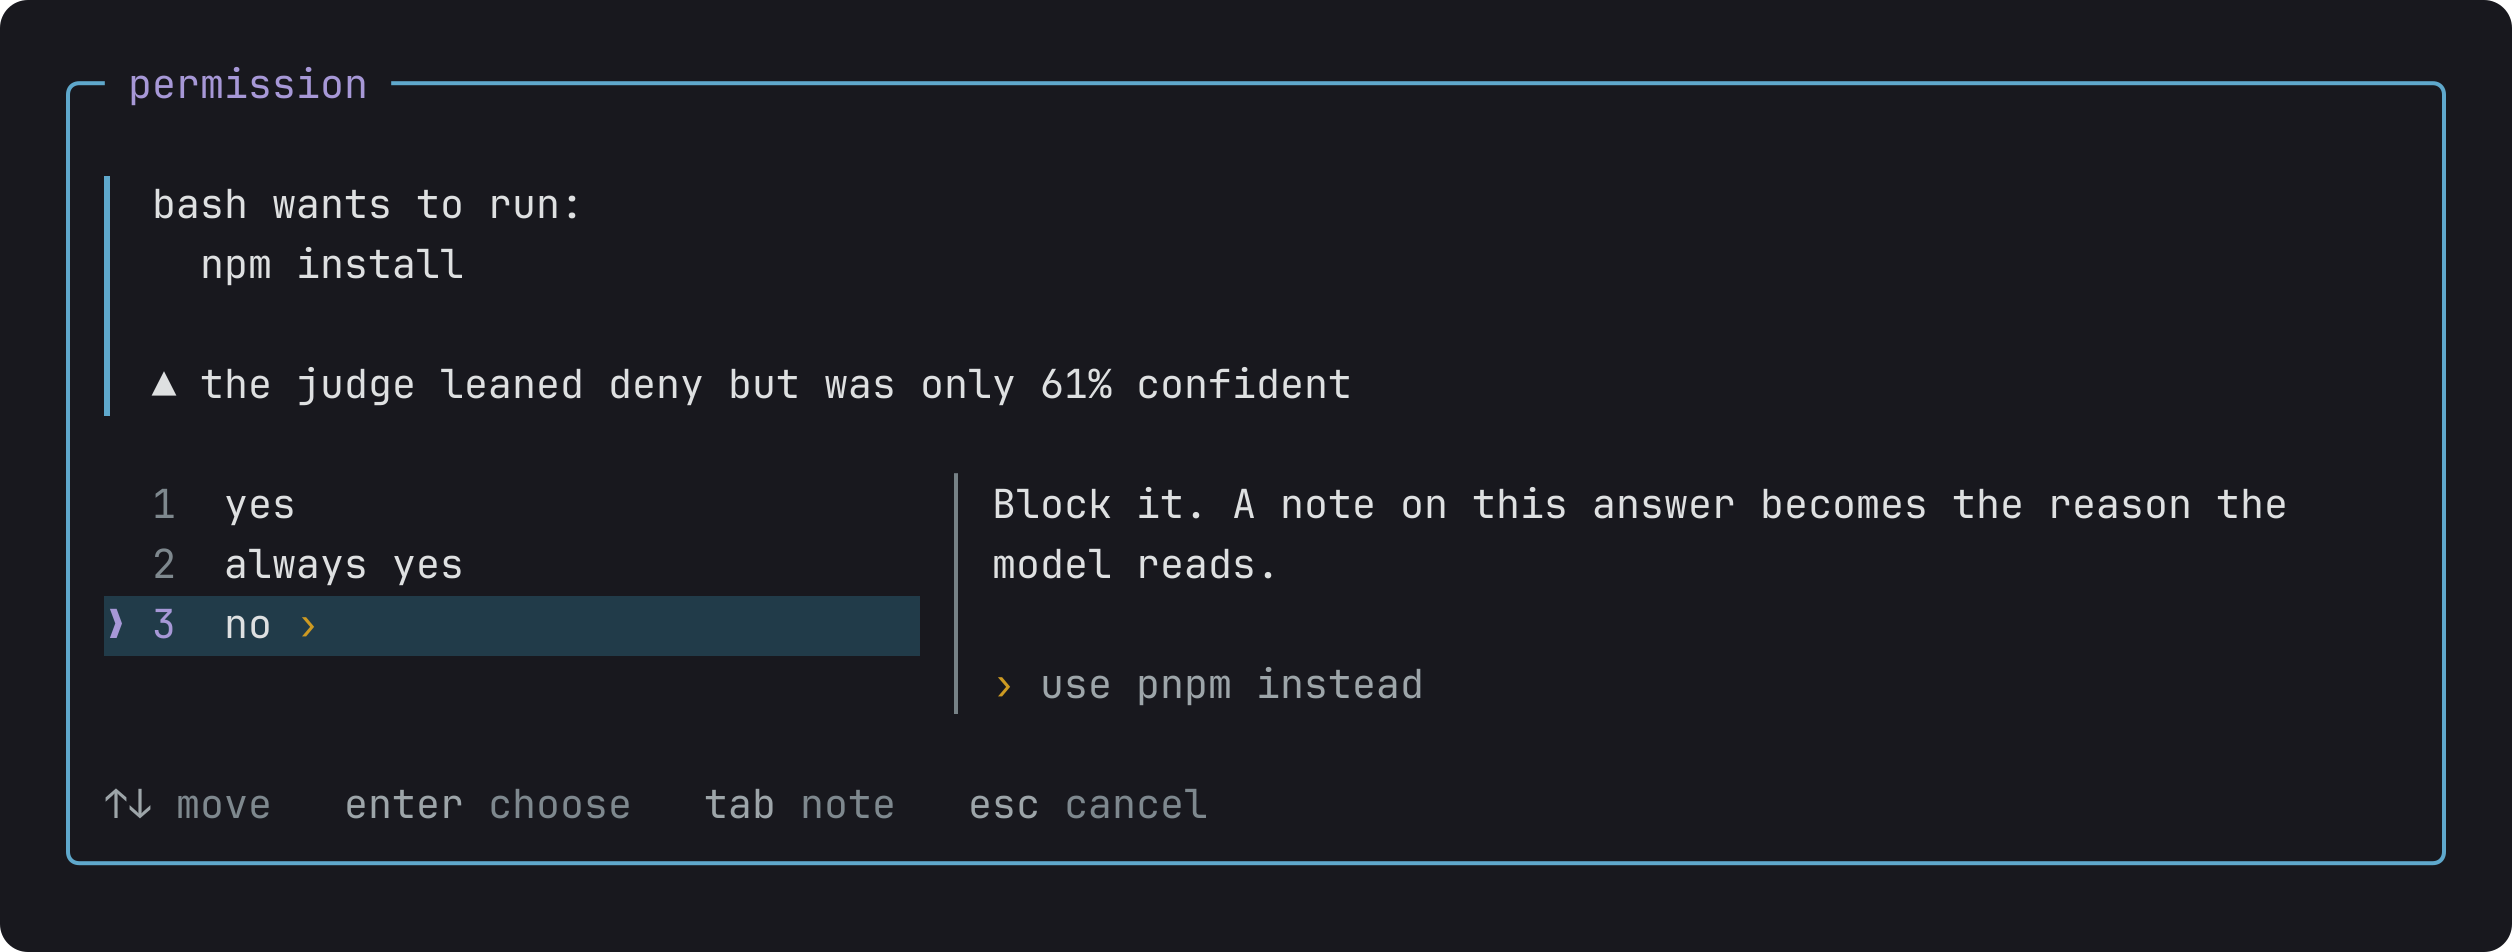
Um no com uma nota que o modelo lê: use pnpm instead.
Repara no no: ele agora carrega um motivo. O agente não recebe só “negado”, recebe o que fazer no lugar. É o item 3 da lista resolvido, e é literalmente fechar o gap.
Depois do lançamento do Jev, da Typesafe, um modelo classificador, eu dei um juiz a ela. Um modelo pequeno lê a chamada (a tool e os argumentos) e decide se ela roda sozinha ou se vem pra mim:
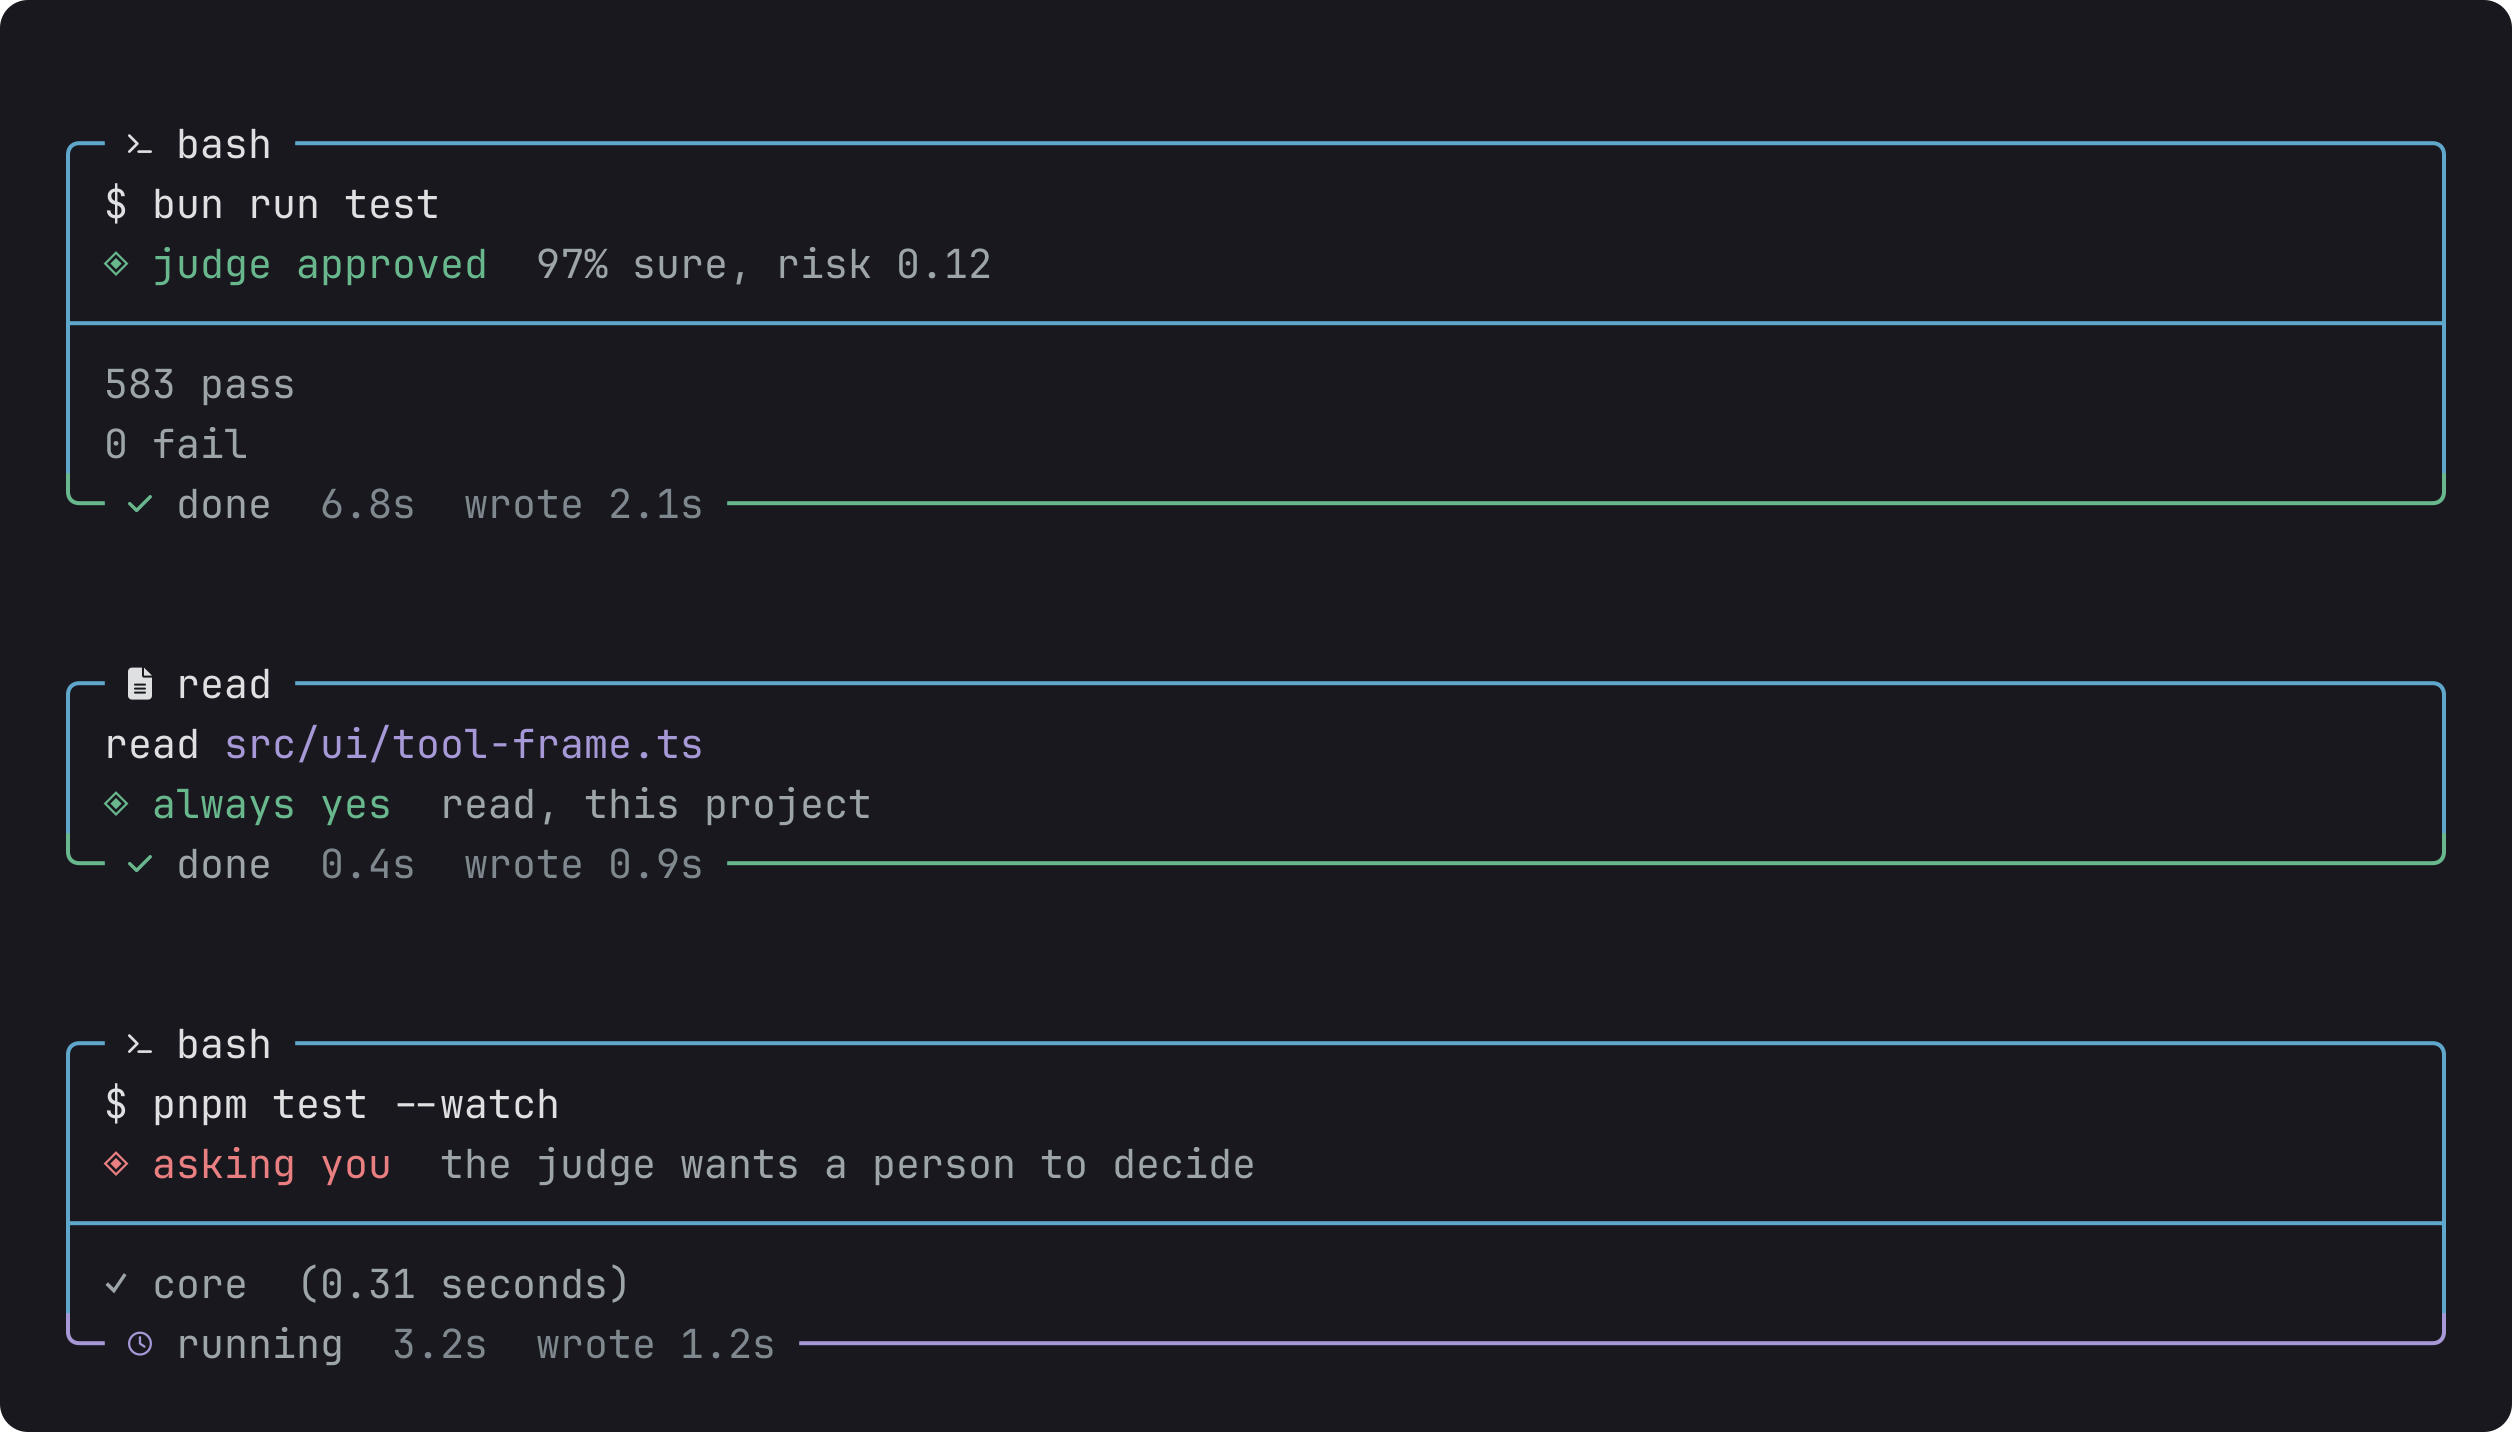
Uma chamada que o juiz aprovou, uma que um always yes liberou, e uma que veio pra mim.
E Adeildo disse: haja harness opinionated!§
Nem tudo são flores. Aos poucos, aquilo virou um Frankenstein de extensões de terceiros. Não é ruim, mas umas coisinhas incomodavam. Cheguei a abrir PR pra resolver algumas, mas é a minha opinião contra a dos mantenedores, e o tempo de resposta não era tão rápido quanto eu queria pra ter a última versão das coisas na minha máquina.
Então resolvi reimplementar tudo num monorepo, com estado compartilhado e um padrão de UI. Algo bem parecido com o que o omp se propõe a fazer, só que sem virar fork.
Assim nasceu o @adeildo/pi-harness: tudo que eu uso no dia a dia, do jeito que eu acho que essas ferramentas deveriam funcionar e parecer. A experiência que eu, como dev, queria ter montando um LLM qualquer.
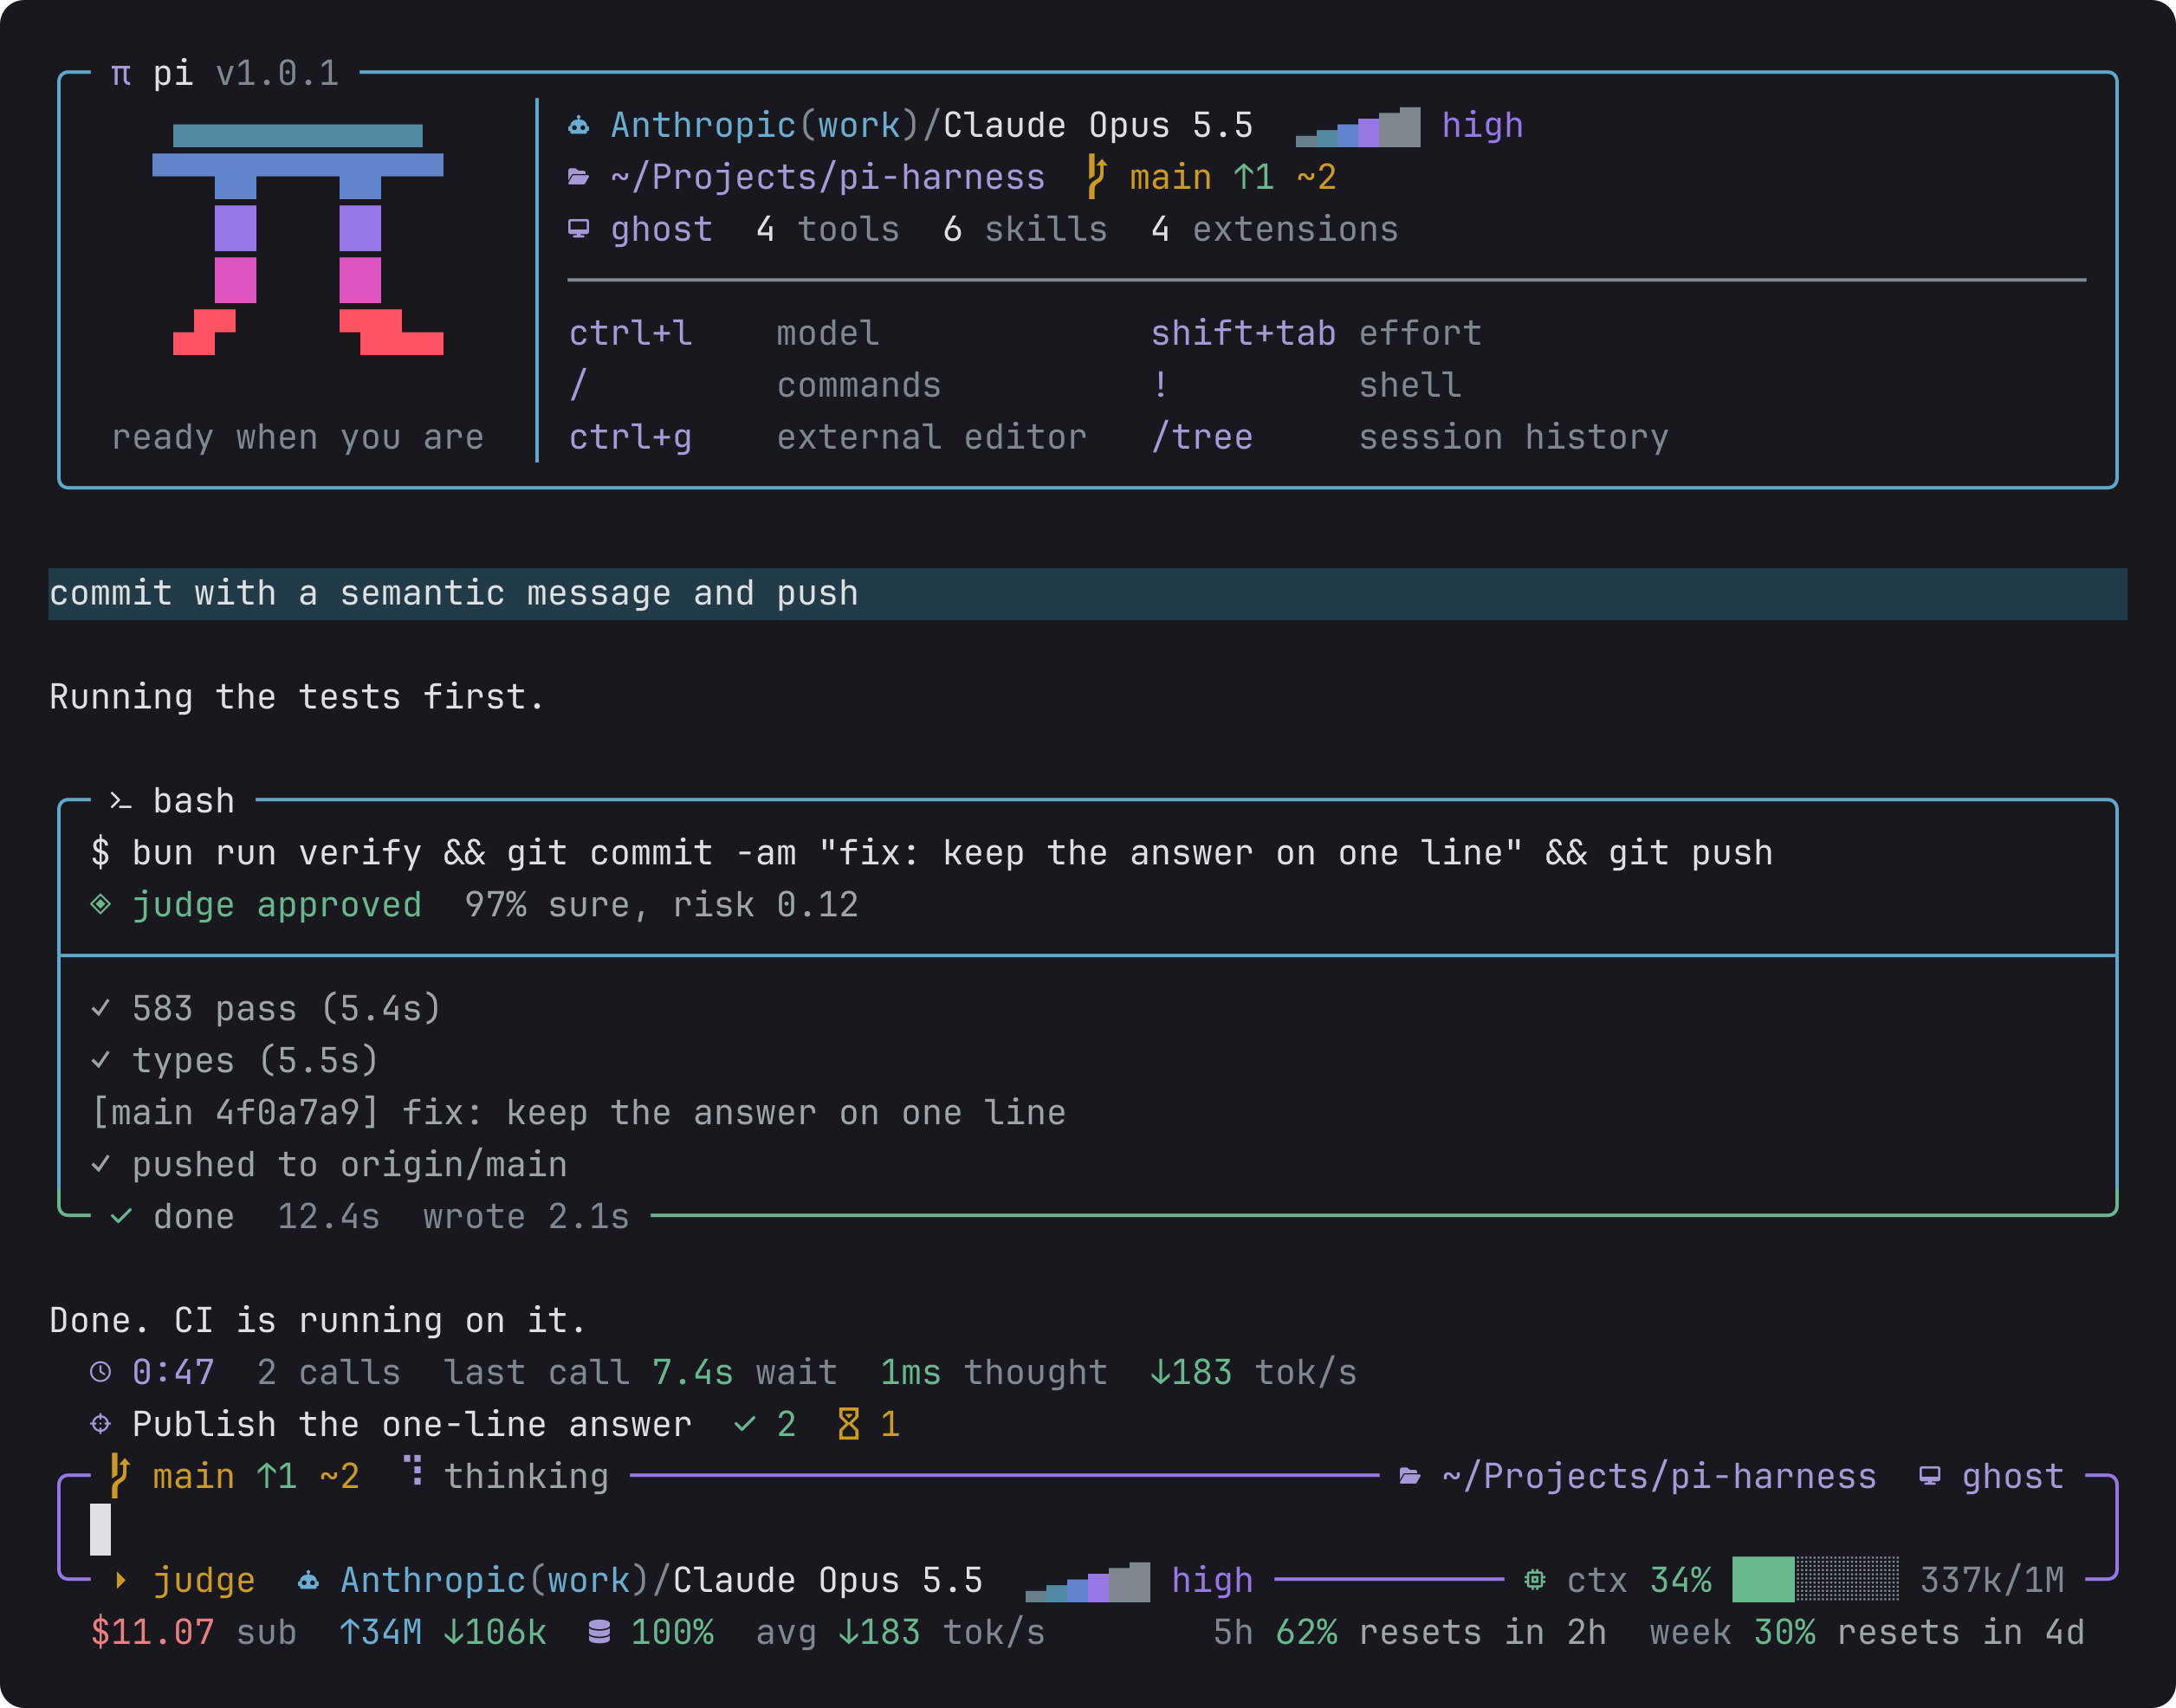
Uma sessão inteira: o card de início, o pedido, o juiz liberando o commit, e o rodapé dizendo quanto custou e quanto sobra do plano.
E tem umas regras das quais eu não abro mão:
- Bonito, elegante, confortável e intuitivo.
- Nada de 1001 comandos pra fazer coisas distintas: uma tela de configuração, no Alt+S.
- Poucos passos e você tá PRONTO pra usar.
- Sem fork. O
pi removedevolve o pi do jeito que estava.
Como as peças se encaixam§
São quatro peças, e todas são features de uma mesma biblioteca, o kit. Uma peça nunca importa a outra: elas conversam por contratos, eventos em JSON puro trafegando no pi.events.
flowchart TB
    subgraph H["@adeildo/pi-harness"]
        direction TB
        P["permission<br/>pergunta antes de rodar"]
        Q["questions<br/>pergunta em vez de chutar"]
        V["providers<br/>contas e plano"]
        L["look<br/>mostra o que está acontecendo"]
        P -->|desenha o diálogo com| Q
        P -.->|quem decidiu e por quê| L
        V -.->|conta e cota| L
    end
    H --> K["@adeildo/pi-kit<br/>features, settings, Alt+S, contratos"]
    K --> PI["pi, intocado"]
As setas pontilhadas são contratos: se uma peça não está instalada, a outra só não recebe o evento.
Quer uma peça só? Cada uma também é um pacote próprio: pi install npm:@adeildo/pi-look traz a tela e mais nada. E o pi config desliga qualquer uma delas.
Permission: pergunta antes de rodar§
O pi, de fábrica, roda qualquer comando sem perguntar. Essa peça faz ele perguntar, e responde as perguntas fáceis por você. Toda chamada passa por aqui:
flowchart TD
    call["o modelo quer rodar algo"] --> rule{"alguma regra<br/>já responde?"}
    rule -->|"leitura, always yes,<br/>ou o modo"| run["roda"]
    rule -->|não| judge["o juiz lê a chamada"]
    judge -->|tem certeza que tá ok| run
    judge -->|na dúvida| ask["vem pra você,<br/>com o motivo"]
    ask -->|"yes ou always yes"| run
    ask -->|"no + nota"| block["bloqueia, e a sua<br/>nota chega no modelo"]
Ela começa no modo mais conservador (adeus, item 1 da lista), e Alt+M troca de modo:
| Modo | Roda sem perguntar |
|---|---|
manual |
Leituras e o que você marcou como always yes. É o padrão |
edits |
O mesmo, mais edição e escrita de arquivo |
judge |
O mesmo que edits, e o juiz decide o resto |
full |
Tudo. Boa sorte |
Uma regra vale acima do modo: chamada fora do workspace sempre pergunta, até no full. O Alt+W libera isso pela sessão, com um anywhere em vermelho na barra de status pra você não esquecer.
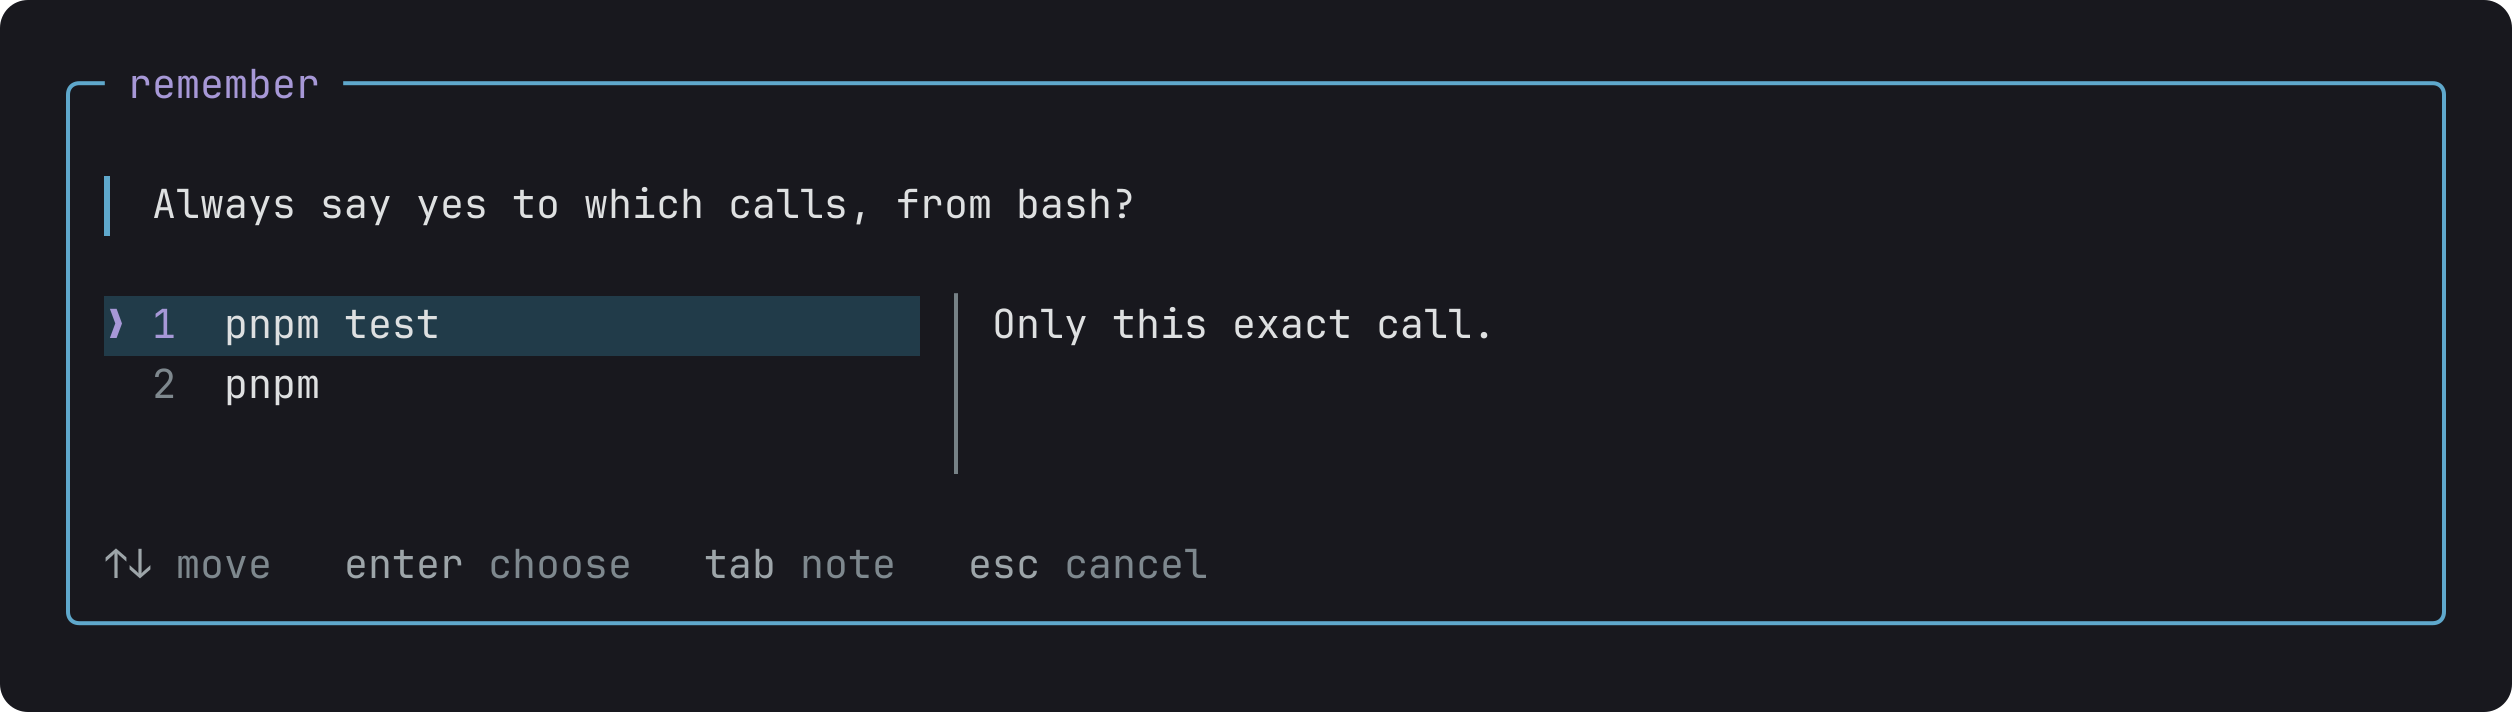
O always yes pergunta o quê lembrar, e depois por quanto tempo: a sessão, o projeto, ou todo lugar. A primeira opção é sempre a mais estreita, e é a que você quer: pnpm aprovaria pnpm publish junto.
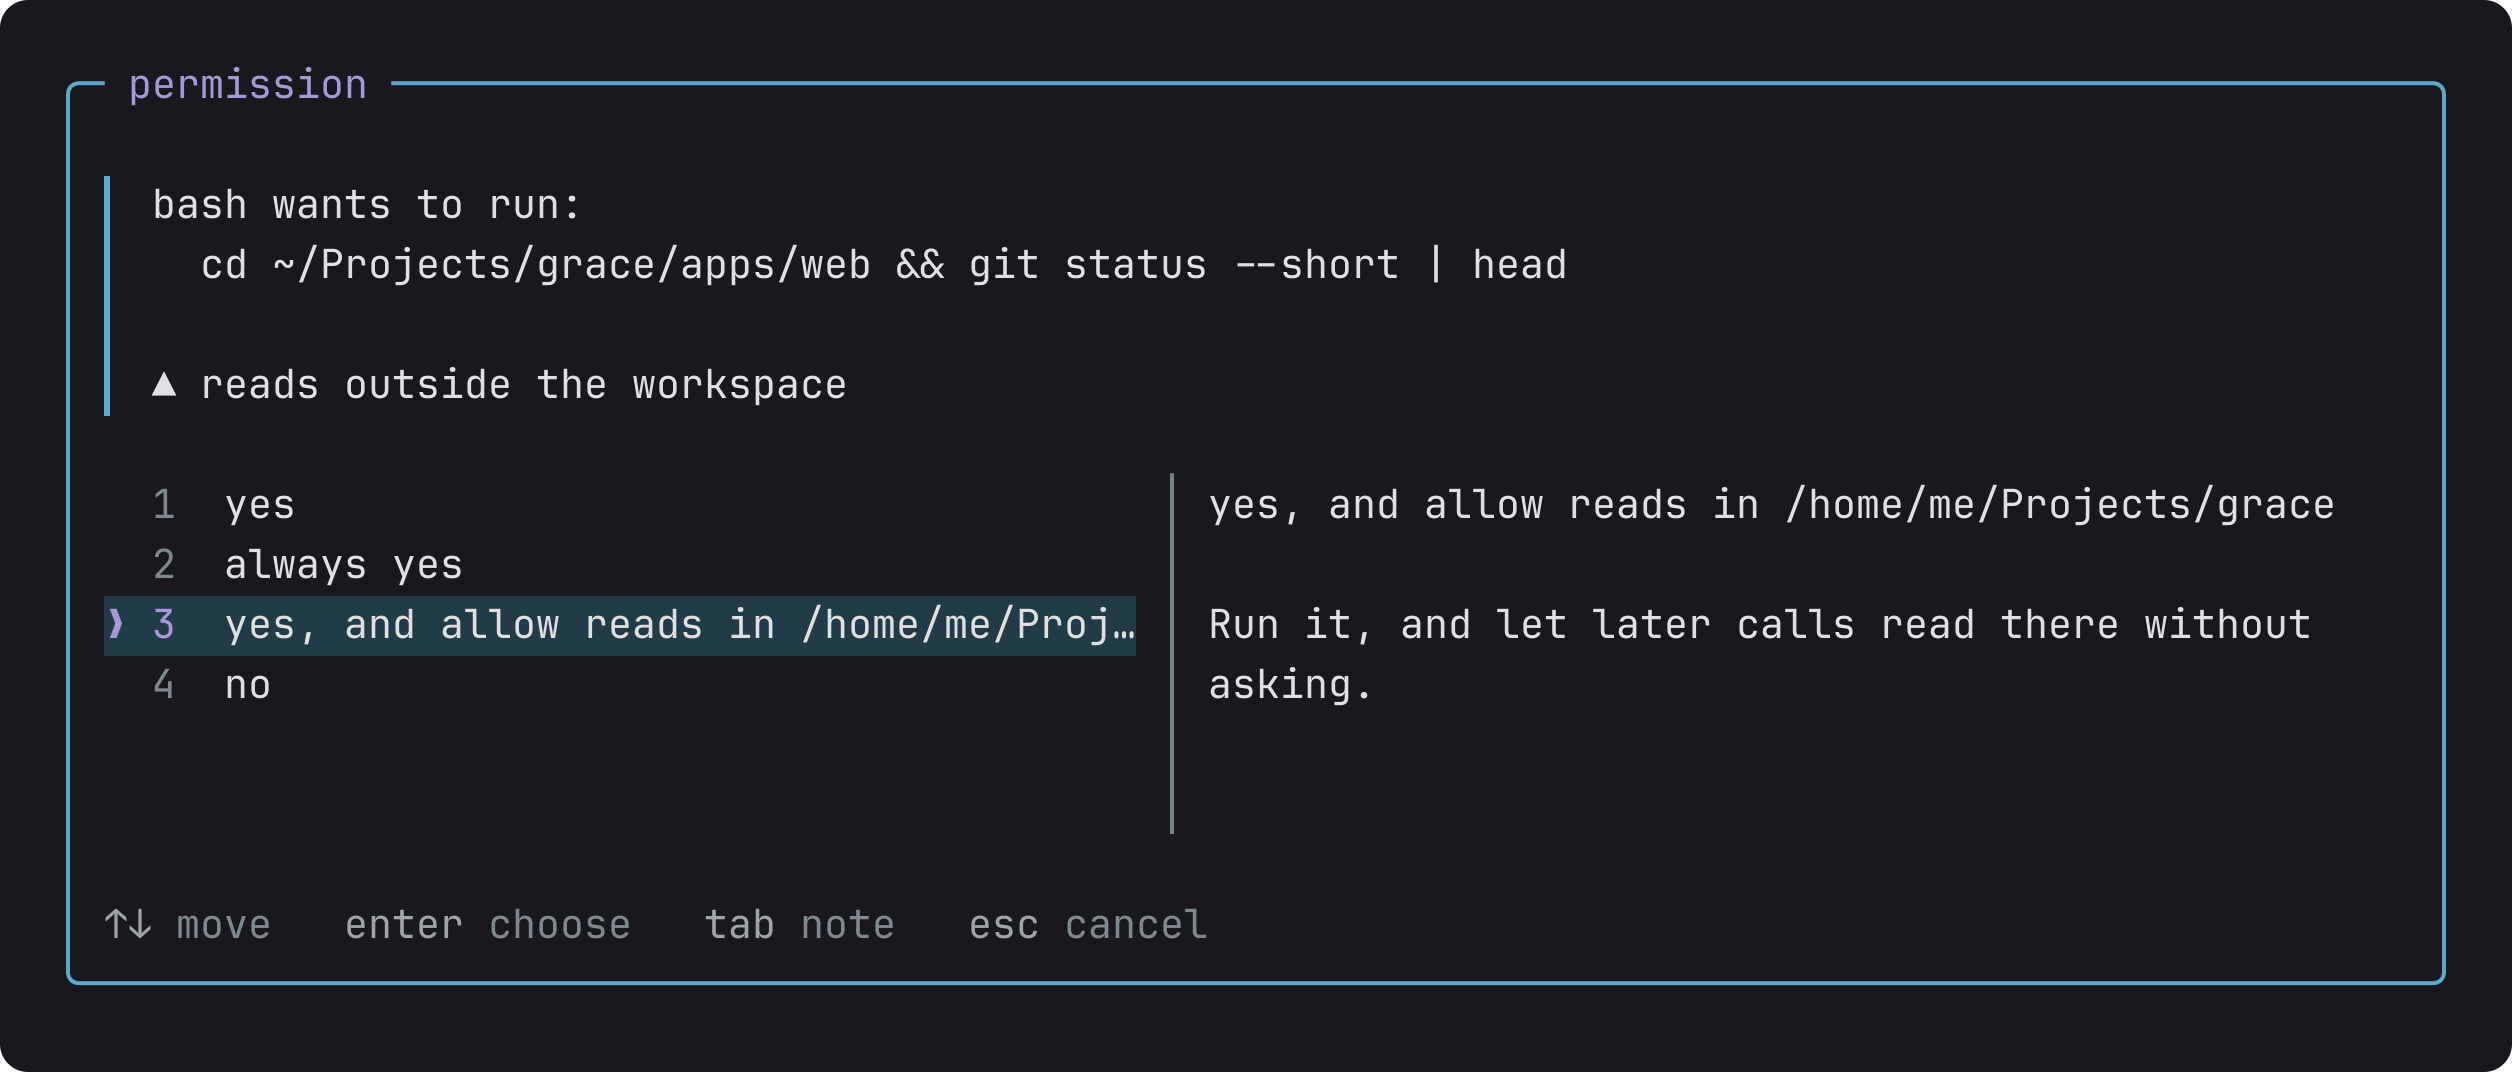
Num monorepo, uma sessão em apps/api que lê apps/web sai do workspace. O diálogo avisa, e oferece abrir aquela pasta só pra leitura. Escrita lá fora continua perguntando.
Como o juiz decide
No modo judge, um modelo responde toda chamada que não é leitura nem edição, então você só vê as que ele duvidar. Ele roda nos classificadores do próprio pi (ctx.modelRegistry.classify()), então não tem prompt meu nem provider meu pra manter.
Uma chamada roda quando o juiz aprova com pelo menos a confiança do rigor escolhido, e o risco fica abaixo do teto:
| Rigor | Confiança | Teto de risco |
|---|---|---|
cautious |
85% | 0.45 |
balanced (padrão) |
70% | 0.50 |
relaxed |
55% | 0.60 |
A política é texto puro, então você começa de um preset e edita:
# May run without asking
- Running tests, linters, type checks, and builds
- git status, diff, log

# Must always ask first
- sudo, or anything that changes system-wide state
- Anything that reaches the network

# When in doubt
Ask me.
Começa com o dry run ligado: o juiz escreve o veredito na chamada, mas quem decide ainda é você. Depois de umas sessões concordando com ele, desliga.
Questions: pergunta em vez de chutar§
Essa é a peça que mais conversa com a tese do post. Em vez de chutar quando falta informação, o modelo te pergunta, e cada pergunta vem com opções, um preview do que cada uma vira, e uma linha pra você escrever a sua própria resposta.
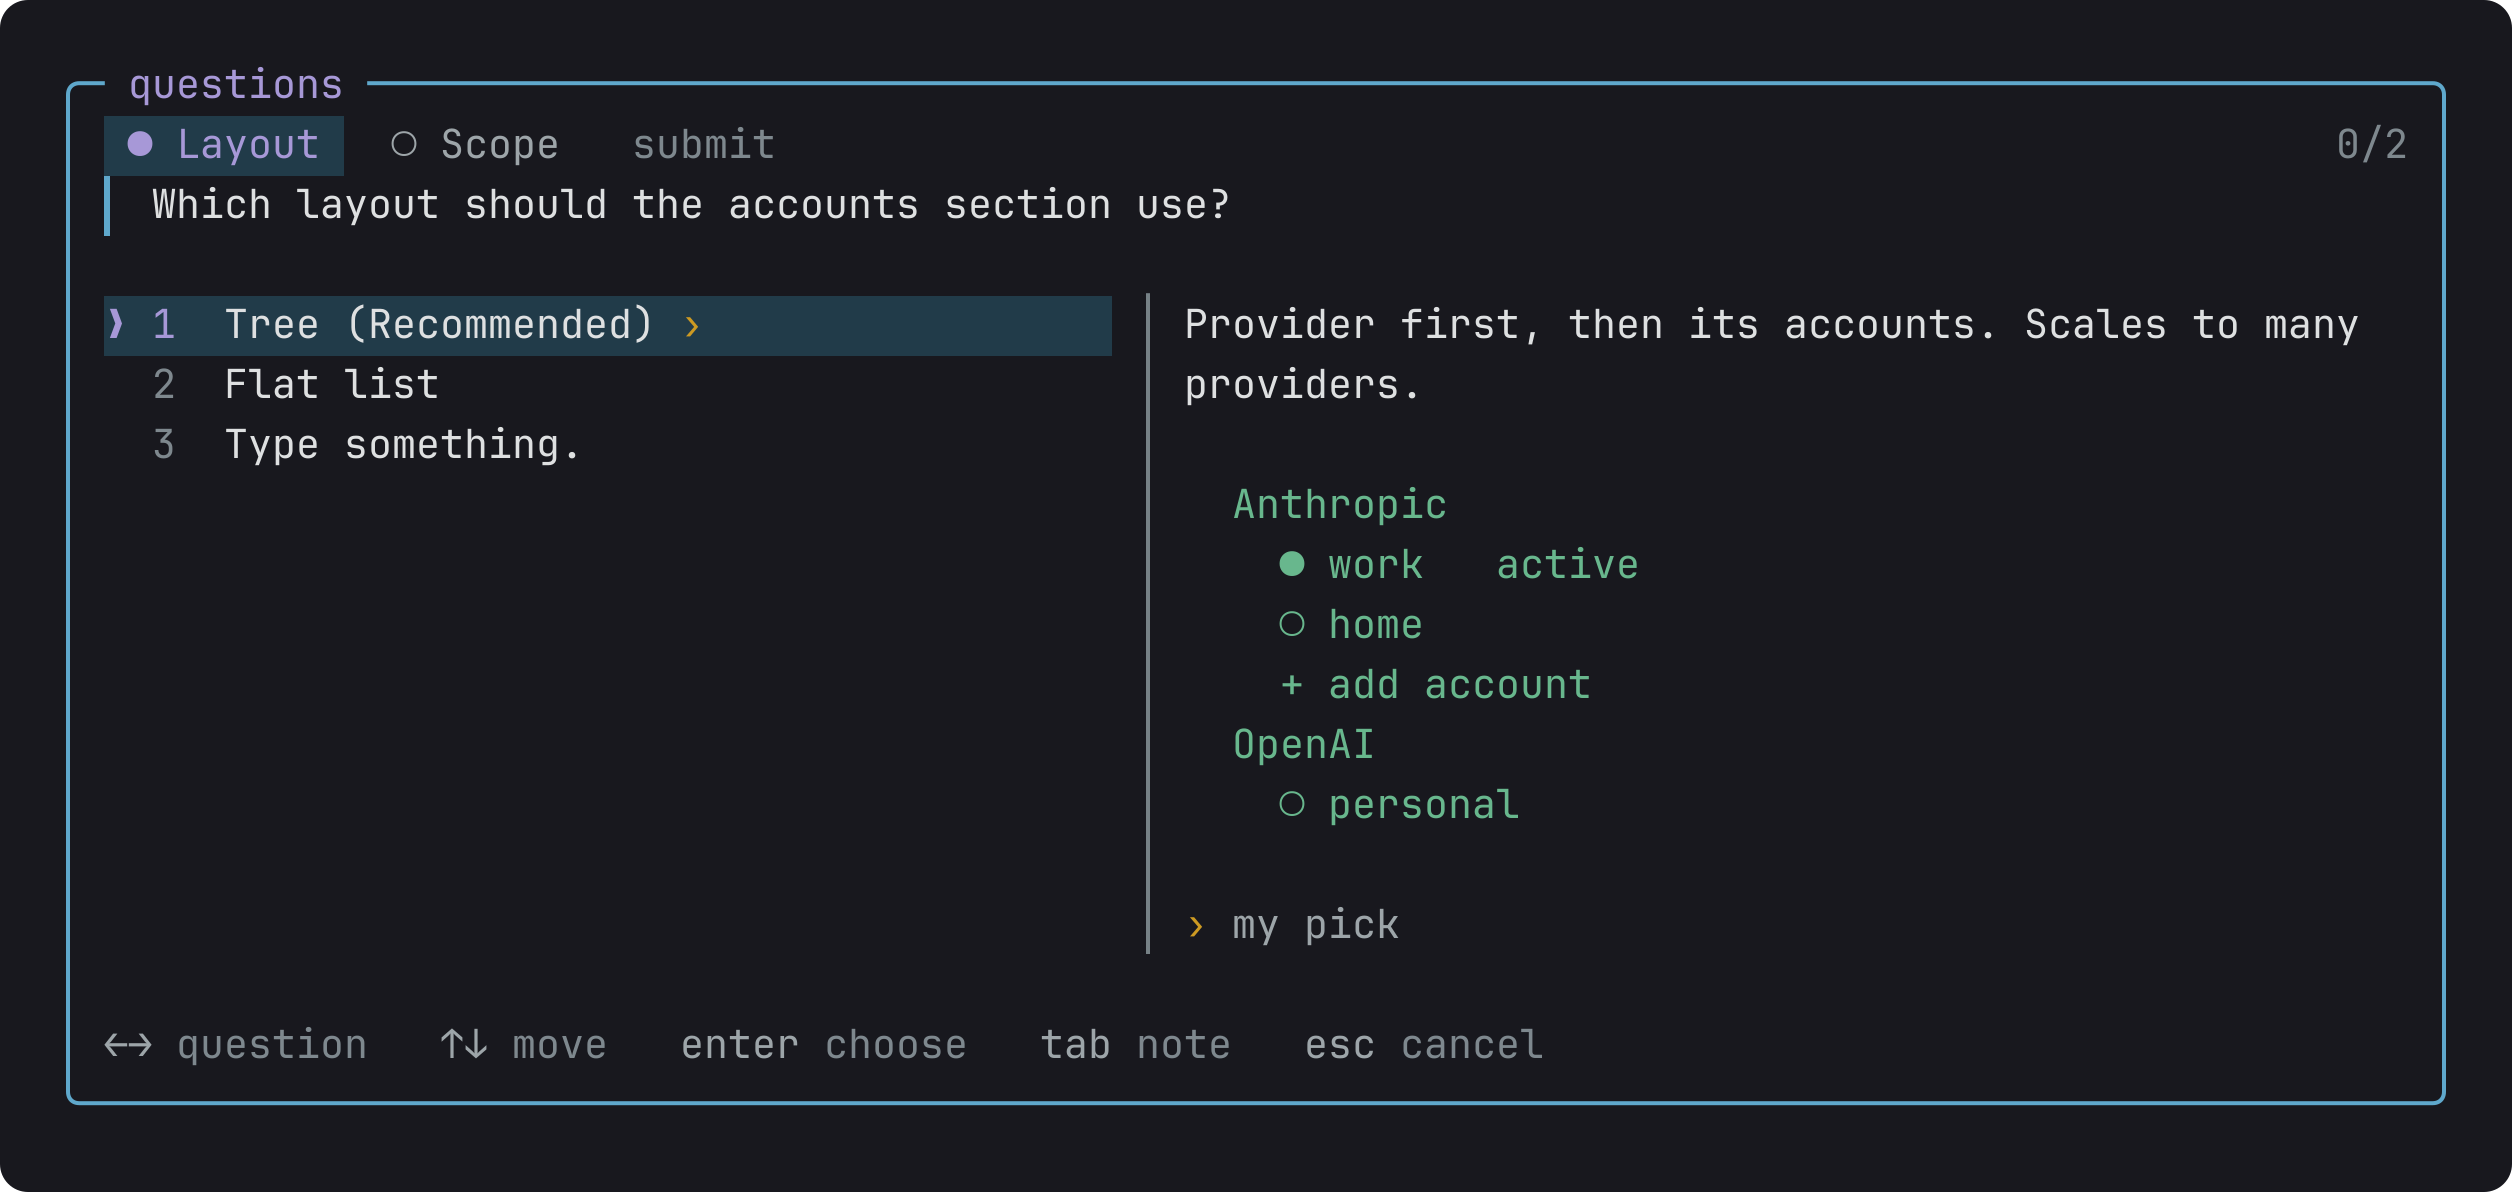
Duas perguntas em abas, e o preview da opção em foco.
O pulo do gato são as notas: Tab escreve uma nota em qualquer opção, escolhida ou não. E é isso que o modelo lê de volta:
The user answered:
- Layout: "Which layout should the accounts section use?" → "Tree (Recommended)"
  note on "Tree (Recommended)": fits how I think
  note on "Flat list" (not picked): too long with five accounts
Continue with these answers in mind.
“Muito longo com cinco contas”, numa opção que eu nem escolhi, diz mais pro modelo do que a escolha sozinha. Isso é gap sendo fechado.
E o diálogo de permissão é esse mesmo diálogo por baixo, então os dois têm as mesmas teclas: Up Down pra andar, Enter pra escolher, Tab pra nota, Esc pra sair.
Look: mostra o que está acontecendo§
O item 2 da lista. A tela inteira é desenhada em volta dos números que importam enquanto o agente trabalha.
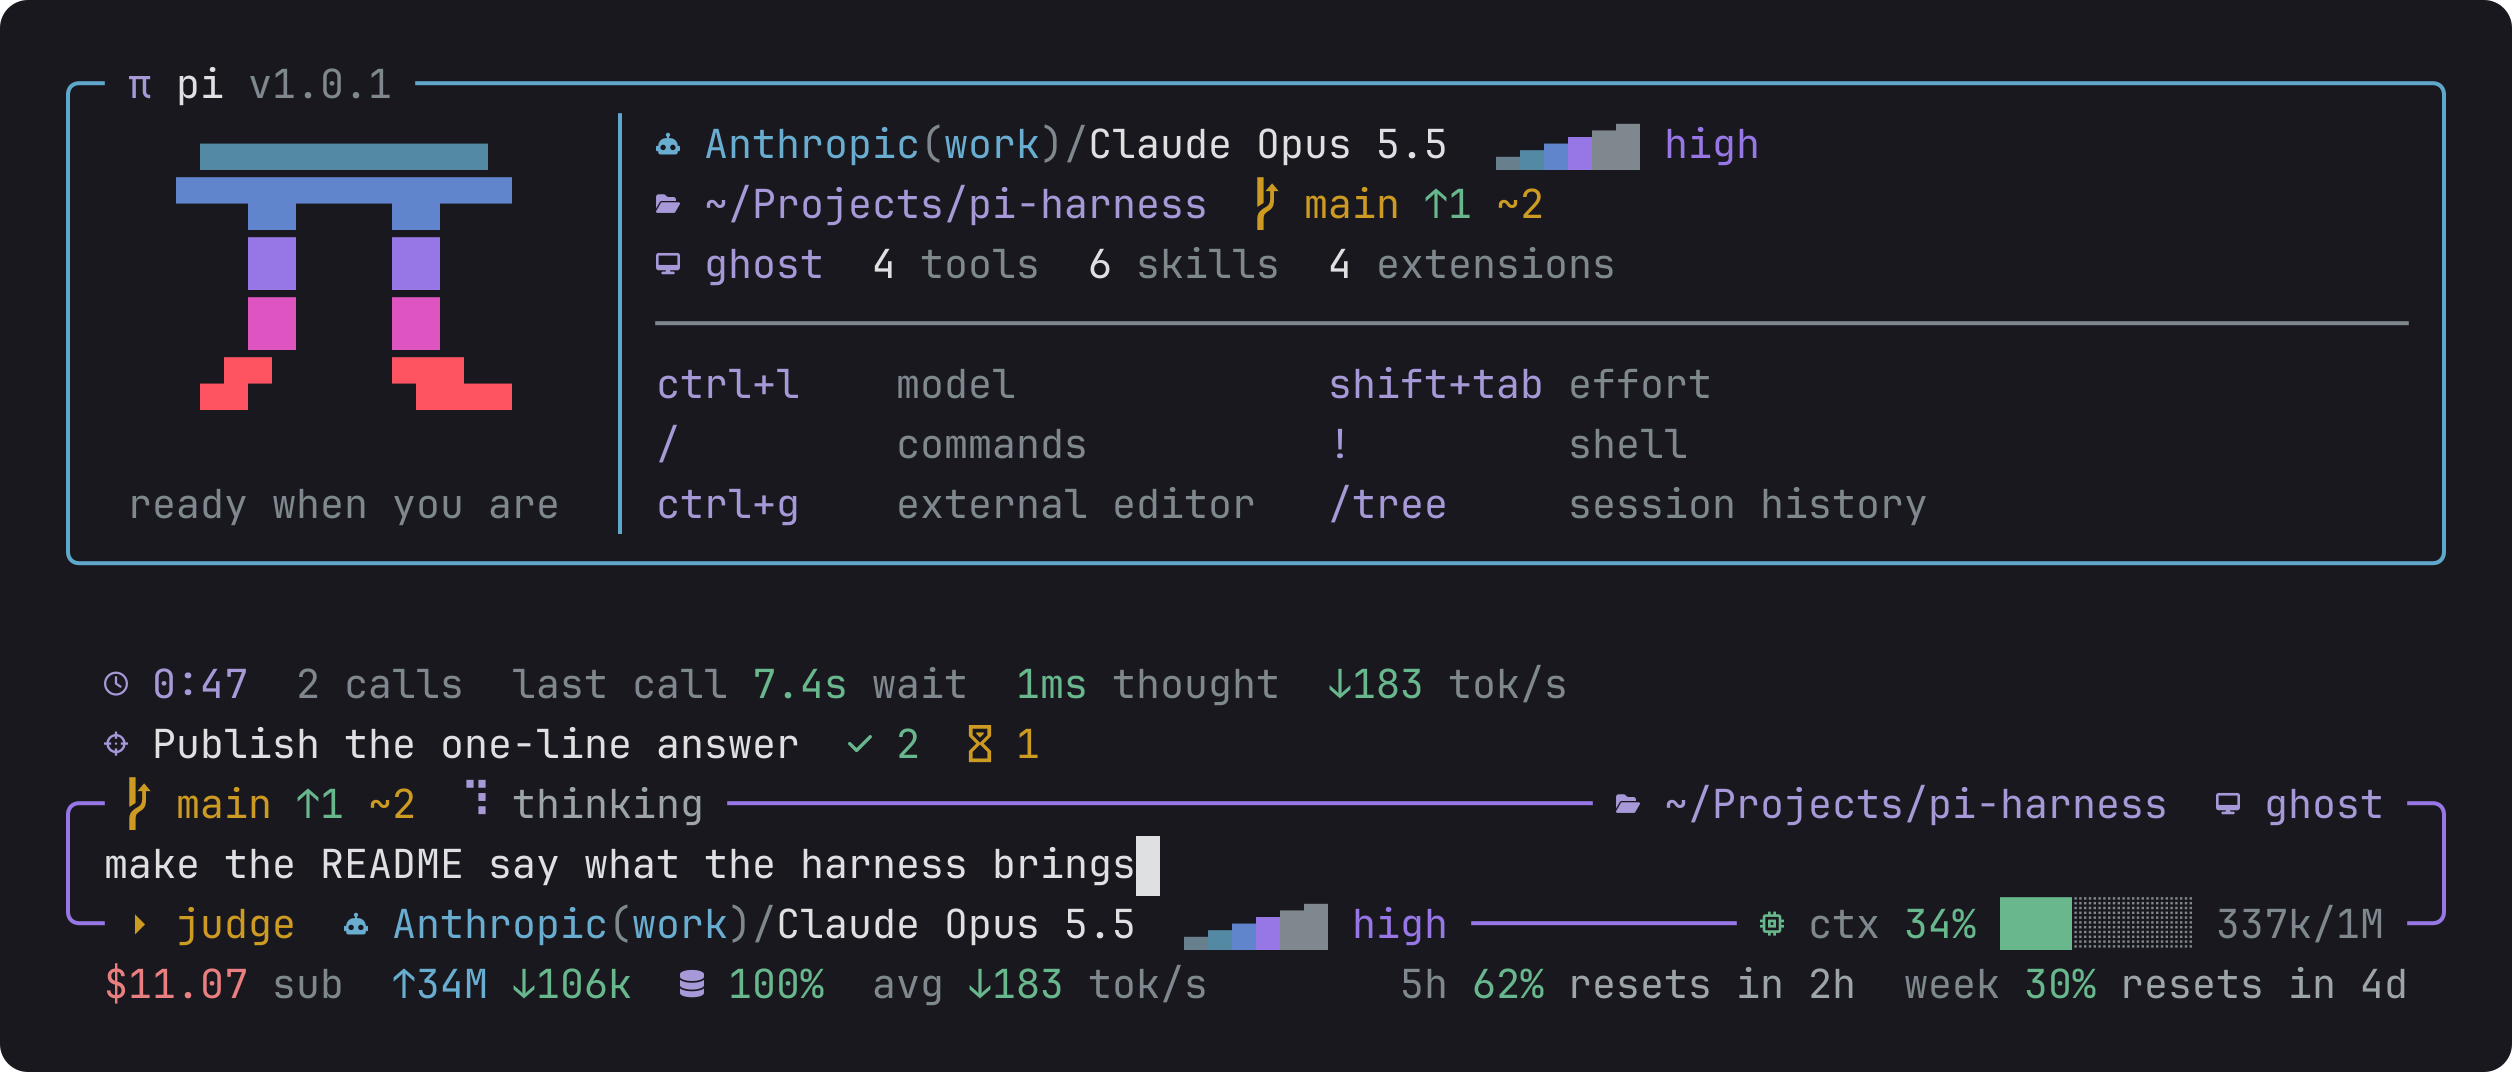
O card de início, e um prompt no meio da resposta.
E toda chamada de tool ganha uma caixa própria (aquela lá de cima, do juiz): o que vai rodar, quem deixou e por quê, o output, e quanto tempo levou.
A tela não dança
Não sou o melhor cara de design, mas sei muito bem o que me incomoda numa UI. E o que mais me incomoda é tela dançando: um contador sem número tabular, que empurra a linha inteira pro lado toda vez que passa de 9 pra 10, ou um valor que surge do nada no meio da linha e desloca todo o resto.
Então aqui é TOC assumido: todo número tem largura fixa, valor que ainda não existe aparece como – em vez de brotar depois, e a faixa e o rodapé já nascem ocupando a linha deles. O cronômetro corre e mais nada se mexe.
Providers: o plano que você já paga§
Com um plano Pro ou Max conectado no /login anthropic, as requisições do pi contam como extra usage, cobrado por token. Essa peça faz elas saírem do plano, igualzinho às do Claude Code.
Lê as letras miúdas
Ela faz isso apresentando o pi pra Anthropic como Claude Code, e usar a assinatura fora do Claude Code pode quebrar os termos da Anthropic. Não quer isso? Desliga a feature no pi config. Requisição com API key sai intocada.
E ela guarda várias contas por provider. O /accounts adiciona usando o próprio login do pi (nada de OAuth meu), Alt+A troca a conta da sessão, e cada uma mostra quanto do plano ainda tem. Quando uma bate no limite, a próxima assume:
sequenceDiagram
    participant pi
    participant W as conta work
    participant H as conta home
    pi->>W: requisição
    W-->>pi: 429, limite atingido
    Note over pi: accounts.onLimit = ask, switch ou stop
    pi->>H: a mesma requisição
    H-->>pi: resposta
Só troca se nada foi mostrado ainda, então um retry nunca repete na sua cara um texto que você já leu.
O kit, pra quem quer escrever a própria peça§
Por baixo de tudo isso tem o @adeildo/pi-kit. Uma feature é um objeto, e o kit dá a ela settings tipadas, uma aba no Alt+S e um interruptor no pi config:
import { createApp, defineFeature, matching, setting } from "@adeildo/pi-kit";
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export const version = setting({
    id: "subscription.claudeCodeVersion", // (1)!
    default: "2.1.280",
    decoder: matching(/^\d+\.\d+\.\d+$/, "a version like 2.1.280"), // (2)!
});

export const subscription = defineFeature({
    id: "subscription",
    description: "Bill Anthropic OAuth requests to the Claude plan",
    settings: [version],
    setup(scope) { // (3)!
        scope.on("before_provider_headers", (event) => {
            event.headers["user-agent"] = `claude-cli/${version.get(scope)}`;
        });
    },
});

export default function (pi: ExtensionAPI): void {
    createApp(pi, { name: "pi-harness" }).use(subscription).build();
}
- O
idé o caminho da chave no arquivo de settings, que todas as peças compartilham. - Valor que não decodifica é ignorado, com um aviso dizendo o arquivo e a chave.
- O
scopeé a própria API de extensão do pi, com os erros já prefixados com o nome da feature. Feature desligada nunca roda osetup, então não registra nada e não custa nada.
A lista de reclamações, revisitada§
Prometi que ela voltava:
| O que me deixava puto | Onde o harness resolve | |
|---|---|---|
| 1 | Editar tudo by default | Permission começa no manual, e cada modo é uma escolha sua |
| 2 | Visibilidade truncada | Look: cada chamada numa caixa, com quem decidiu, o output e o tempo |
| 3 | Permissão binária | O no leva uma nota, e o modelo ainda pode perguntar antes de chutar |
| 4 | Não eram o Claude Code | O diálogo, os modos e o juiz no espírito do Claude Code, em cima de qualquer modelo |
| 5 | Performance | O pi já é leve, e o look só redesenha uma chamada quando ela muda, com um teste de performance guardando isso |
O que vem por aí§
Hoje o harness ainda é bem vanilla em memória, acesso à web, acesso remoto e multi-agent. É pra lá que ele vai:
- Permissão com nota, modos, always yes em três escopos, e o juiz
- Perguntas com preview e nota
- O look: card de início, editor emoldurado, caixa por chamada, rodapé
- Várias contas, troca no limite, e o plano no rodapé
- Um ledger de uso, e um
/usagecom o que o plano diz que sobra do lado do que eu gastei - Estado de sessão, compaction estruturada e memória (no lugar do pi-memory)
- Sessões conversando entre si, e subagents com os diálogos de permissão encaminhados pro pai
- Busca e leitura na web (no lugar do pi-web-access)
- Uma ponte remota e uma web UI, pra aprovar chamada pelo celular com a mesma política
O plano inteiro, com o porquê de cada item, está no ROADMAP.md.
Considerações§
Tenho opinião forte sobre muita coisa aqui, deu pra perceber. Mas opinião forte não é o mesmo que saber tudo, e seria muita prepotência minha fechar este post achando que eu sou melhor que a IA.
Não sou. No máximo, sou bem mais eficiente: meu cérebro roda com uns 20 watts. Guardo mais contexto do que qualquer LLM que existe hoje, e o meu retrieval é muito melhor. Uma conversa de três anos atrás volta inteira por causa de um cheiro. Por outro lado, sou lento pra caramba em muita coisa em que o modelo é melhor que eu, com folga: ler vinte arquivos em segundos, escrever trezentas linhas sem errar um nome, fazer a mesma refatoração em cinquenta lugares sem perder a paciência.
Então a ideia nunca foi escolher um lado. É juntar o melhor de mim com o melhor do modelo, pra essa porra toda render mais. Eu entro com a intenção, o contexto e o julgamento, e ele entra com a velocidade. O harness é só o encaixe entre os dois.
O que eu ainda não sei (e quero muito aprender)§
E tem muita coisa que eu não sei. O harness resolve o meu dia a dia, mas é o arroz com feijão. Enquanto isso, a galera está fazendo coisa bem mais interessante, e é pra onde a minha curiosidade está indo:
- Memória de longo prazo. A minha é markdown com busca. O Zep guarda a memória como um grafo temporal, em que um fato que mudou invalida o antigo em vez de competir com ele. A Letta faz sleep-time compute: o agente reorganiza a própria memória no tempo ocioso. E o AgeMem transforma guardar, buscar e esquecer em tools, e treina o modelo pra decidir quando usar cada uma.
- Aprender comigo. Lembrar não é obedecer. Um paper de junho mostra que, mesmo com memória, 57,5% das preferências que o usuário já tinha corrigido continuavam sendo violadas. A proposta deles é minerar as correções da conversa e compilar cada uma numa checagem que roda antes do agente dar a tarefa por terminada. O continualcode vai mais longe: quando você nega uma tool com um motivo, ele dá um passo de gradiente num LoRA e tenta de novo. Meu
nocom nota é exatamente esse sinal, e hoje ele morre no fim da sessão. - Desenvolver em loop. O Ralph, do Geoffrey Huntley, na forma mais pura, é isso aqui:
while :; do cat PROMPT.md | claude-code ; done. Parece piada, e mesmo assim tem gente entregando repositório inteiro durante a noite com ele. O engenheiro para de escrever código e passa a programar o loop. - A fábrica de software. A Anthropic botou 16 agentes em paralelo pra escrever um compilador de C em Rust: umas 2 mil sessões em duas semanas, quase US$ 20 mil, e saíram 100 mil linhas que compilam o Linux 6.9. O Cursor deixou centenas de agentes rodando por quase uma semana e saiu um navegador do zero, com mais de um milhão de linhas. A pergunta que fica: com dinheiro infinito, dá pra fazer software infinitamente bom?
- Revisar PR. Se o agente escreve mil linhas por hora, o gargalo vira quem revisa. A resposta da vez é quebrar o PR gigante numa pilha de PRs pequenos, cada um revisável sozinho. Ainda não sei qual é o meu jeito de revisar rápido sem mentir pra mim mesmo.
- Agentes que conversam e se organizam. O Gas Town, do Steve Yegge, orquestra 20 a 30 instâncias de Claude Code de uma vez (“Kubernetes e Temporal tiveram um filho feio”, nas palavras dele). O A2A quer ser o protocolo pra agentes de fornecedores diferentes conversarem. Eu ainda não consigo fazer duas sessões minhas trocarem um bilhete.
- Acesso remoto. O Claude Code já deixa continuar uma sessão local pelo celular. No meu roadmap isso ainda é um item
later, com o Tailscale como provável porta de entrada.
Não revisar PR? Calma lá
A fábrica da StrongDM tem duas regras: código não pode ser escrito por humano, e código não pode ser revisado por humano. E uma métrica: se você não gastou pelo menos US$ 1.000 em tokens hoje, por engenheiro, a sua fábrica tem o que melhorar.
Eu sou bem cético com isso. Não revisar código me parece estranho, e bem slop. Mas o que eles colocam no lugar da revisão é interessante: cenários de ponta a ponta guardados fora do repositório, como um holdout set, pra que o agente não consiga reescrever o teste pra passar. Ou seja: eles não tiraram a verificação, trocaram quem verifica. Ainda não sei se confio nisso. Mas quero entender antes de descartar.
Será que dá pra juntar tudo com evals?§
Olhando a lista de novo, tem um padrão. O que separa cada uma dessas ideias de um hype é saber medir se funcionou:
flowchart TB
    E(["evals"])
    E --- M["memória<br/>lembrou do que importava?"]
    E --- A["aprender comigo<br/>parou de repetir o erro?"]
    E --- L["loop<br/>sabe quando parar?"]
    E --- F["fábrica<br/>os cenários fora do repo"]
    E --- R["revisão<br/>o que eu preciso olhar?"]
    E --- J["o juiz<br/>concorda comigo?"]
Sem um jeito de medir, cada uma dessas ideias é só uma opinião com mais tokens.
O dry run do meu juiz já é um eval tosco: ele dá o veredito, eu decido, e eu conto quantas vezes a gente concordou. A Anthropic tem um bom texto sobre evals pra agentes, e eu desconfio que o próximo passo do harness passa por aí. Ainda não sei como. É o que eu quero descobrir.
Sobre o slop: continuo achando que muita coisa nessa área é nome bonito pra pouca coisa. Skill é um prompt em .md, e eu sigo instalando várias, porque um prompt bem escrito, que alguém já testou, economiza meu tempo. Dá pra achar o hype exagerado e usar a ferramenta mesmo assim.
O gap continua sendo nosso§
Importante
O modelo escreve mais rápido que eu, mas quem responde pelo que vai pra produção sou eu. Quando eu não entendo o que está acontecendo na aplicação, na arquitetura, no que estou construindo, o problema raramente é o modelo: é o gap que eu deixei aberto. O harness não fecha ele por mim. Só deixa mais barato eu fechar.
Discorda? Melhor ainda§
Bora conversar
Nada disso é a forma certa de usar agente. É a forma que tem funcionado pra mim, hoje. Se você acha que eu errei em alguma coisa, ou faz diferente e funciona, eu quero muito saber. Seria do caralho ter essa discussão com gente que pensa diferente de mim.
Abre uma issue ou um PR no pi-harness, ou me chama pra conversar. A ideia é construir com carinho, pensando na experiência de cada feature, coisa que nós mesmos usaríamos no dia a dia. Com começo, meio e fim.
É isso. Pra cima! Bora, biu!
-
Um programa inteiro num arquivo só: sem módulo, sem pacote, sem separar responsabilidade. Tudo de cima pra baixo, num
script.pygigante que você roda compython script.pye reza. ↩ -
Sorry, FGV. Em minha defesa, até então não tinha nenhuma regra sobre usar IA :D ↩
-
Hoje a “sintaxe” é um JSON com schema, e os modelos passam por um pós-treinamento só pra escrever esse JSON direitinho. Fica bem mais robusto, mas a ideia é a mesma: o modelo escreve, o harness executa. ↩
See you next time! Adeildo